

Ο κώδικας που παραδίδεται αποτελείται από:
- Τα 3 κύρια προγράμματα:
- forecast.py
- detect.py
- reduce.py
- 3 training προγράμματα που χρησιμοποιήθηκαν για εκπαίδευση μοντέλων.
- 3 προεκπαιδευμένα μοντέλα, ένα για κάθε πρόγραμμα.
Μαζί παραδίδονται ενδεικτικά input files από την εκφώνηση, και output files του προγράμματος reduce.py, για να χρησιμοποιηθούν από τον κώδικα της 2ης εργασίας.
python3 forecast.py -d <dataset> -n <number of time series selected> [-m <model directory>] [-noself] [-nomodel]
Το πρόγραμμα διαλέγει τυχαία n χρονοσειρές από το σύνολο.
Τα -noself, -nomodel εκτελούν το πρόγραμμα χωρίς την εκτέλεση της πρόβλεψης με εκπαίδευση ανά χρονοσειρά, ή της πρόβλεψης από το σύνολο, αντίστοιχα.
By default, θα εκτελεστούν και οι δύο προβλέψεις.
Το όρισμα εκτέλεσης -m ακολουθείται από τη διαδρομή του αποθηκευμένου μοντέλου που θα χρησιμοποιηθεί.
Γρήγορη εκτέλεση: python3 forecast.py -d input/nasdaq2007_17.csv -n 1 -m models/model_forecast
python3 detect.py -d <dataset> -n <number of time series selected> -mae <error value as double> -m <model directory>
Το πρόγραμμα διαλέγει τυχαία n χρονοσειρές από το σύνολο.
Το όρισμα εκτέλεσης -m ακολουθείται από τη διαδρομή του αποθηκευμένου μοντέλου που θα χρησιμοποιηθεί.
Γρήγορη εκτέλεση: python3 detect.py -d input/nasdaq2007_17.csv -n 1 -mae 0.1 -m models/model_detect
python3 reduce.py -d <dataset> -q <queryset> -od <output_dataset_file> -oq <output_query_file> -m <model directory> [-novis]
Το πρόγραμμα παράγει 2 αρχεία εξόδου, με όλα τα δεδομένα των αρχικών αρχείων σε reduced μορφή.
Το -novis όρισμα δεν παράγει γραφικές παραστάσεις για κάθε reduction, χρήσιμο εάν θέλουμε να παράγουμε γρήγορα output files, αλλά όχι εάν θέλουμε να εξετάσουμε το σχήμα τους.
Το όρισμα εκτέλεσης -m ακολουθείται από τη διαδρομή του αποθηκευμένου μοντέλου που θα χρησιμοποιηθεί.
Γρήγορη εκτέλεση: python3 reduce.py -d input/nasdaq2007_17_dataset.csv -q input/nasdaq2007_17_queryset.csv -od out/reduced_dataset -oq out/reduced_queryset -m models/model_reduce_enc
Το πρόγραμμα διαλέγει τυχαία n χρονοσειρές από το σύνολο. Εάν δεν δοθούν οι προαιρετικές μεταβλητές, εκπαιδεύει ένα νέο μοντέλο ανά χρονοσειρά, και φορτώνει ένα προαποθηκευμένο μοντέλο
Αρχικά, ξεκινήσαμε εκπαιδεύοντας ένα μοντέλο με τις default τιμές. Παρατηρήσαμε ότι, ενώ η εκπαίδευση ανά χρονοσειρά πήγαινε καλά, το μοντέλο που εκπαιδευόταν ανά σύνολο χρονοσειρών δεν ήταν καλό, πιθανώς λόγω overfitting.
- lookback: 60
- batch_size: 32
- epochs: 100
- units: 50
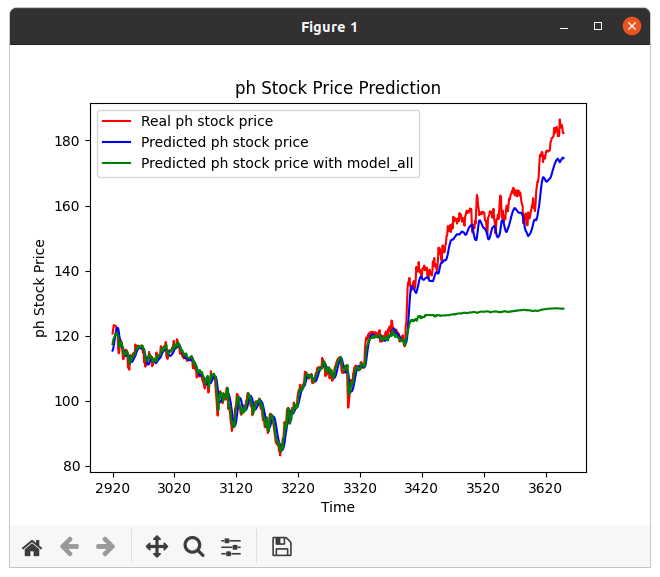
Επειδη ηταν αργο, αφαιρέσαμε 2 layers και μειώσαμε τις epochs στη μέση:
- lookback: 60
- batch_size: 32
- epochs: 50
- units: 50
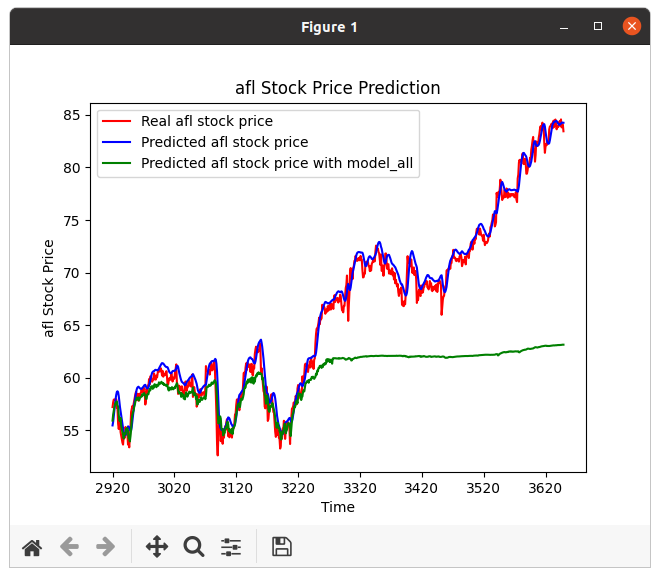
Μετά την αποτυχία καταλάβαμε ότι τελικά χρειάζονται τα εξτρα layers, και για να φτιαξουμε τον χρονο μειωσαμε ελαχιστα τα epochs και αυξησαμε το batch_size
- lookback: 60
- batch_size: 70
- epochs: 45
- units: 50
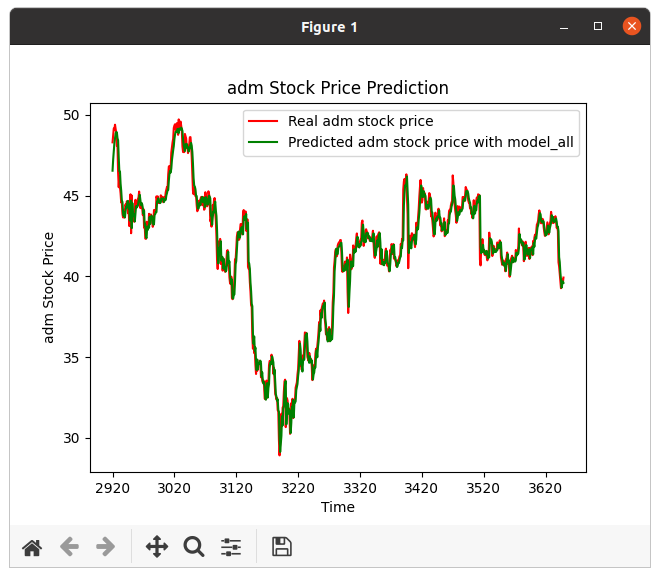
Τελικα, φαινεται οτι τα αποτελεσματα ειναι ικανοποιητικα για τις περισσοτερες χρονοσειρες που δοκιμασαμε, οποτε καταληξαμε σε αυτο το μοντελο.
Ξεκινήσαμε με τις default τιμες:
- TIME_STEPS = 30
- unit_num = 64
- batch_size_num = 32
- epochs_num = 40
- MAE (THRESHOLD) = 1
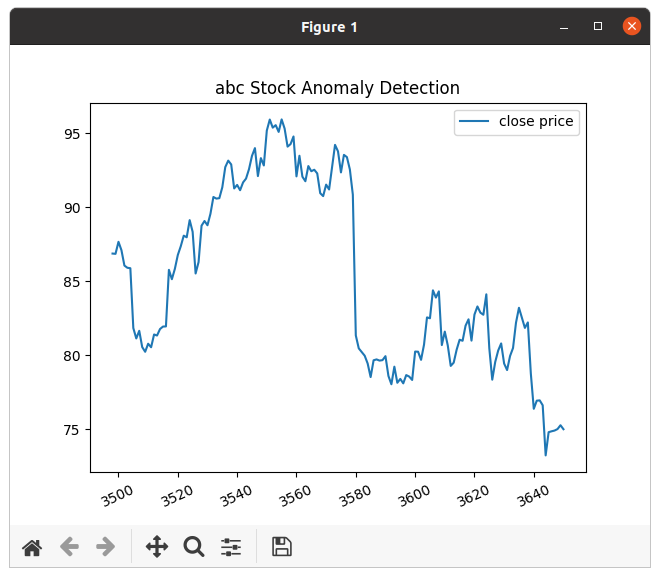
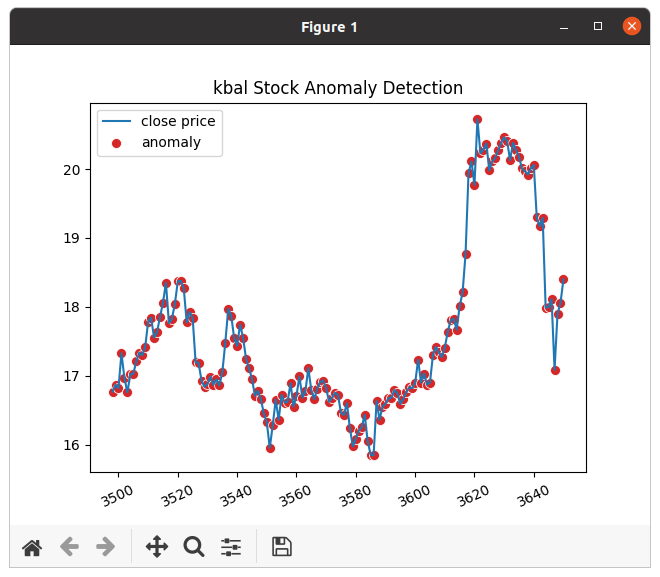
Τελικά διαπιστώσαμε ότι το MAE πρέπει να είναι πολύ μικρότερο για να εντοπίζονται τα anomalies.
- TIME_STEPS = 30
- unit_num = 64
- batch_size_num = 64
- epochs_num = 40
- MAE (THRESHOLD) = 0.1
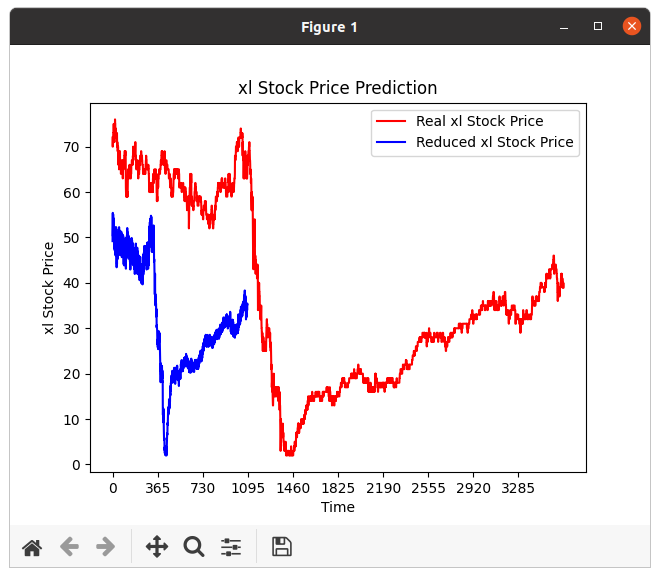
Στο Γ, κρίνουμε την μετοχή από τις τιμές που παίρνει και από το σχήμα της. Όταν φαίνεται από το γράφημα που παράγεται ότι η μετοχή είναι μια "συμπιεσμένη" μορφή της αρχικής μετοχής, τότε θεωρούμε την μείωση επιτυχημένη, εφ' όσον οι τιμές της νέας μετοχής είναι φυσιολογικές και όχι υπερβολικά χαμηλές ή υψηλές.
Ξεκινήσαμε χρησιμοποιώντας τις default τιμες -window_length = 10 -encoding_dim = 3 -epochs = 100 -test_samples = 2000
Τα αποτελέσματα δεν ήταν καλά... ενώ η μετοχή που παραγόταν θύμιζε τη μετοχή μας σε σχήμα, οι reduced τιμές ήταν πολύ μεγαλύτερες από τις αρχικές, σχεδόν 10πλάσιες!
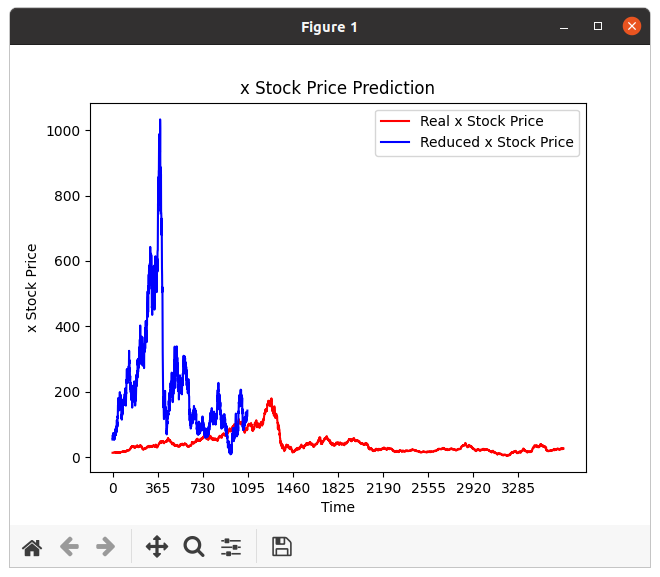
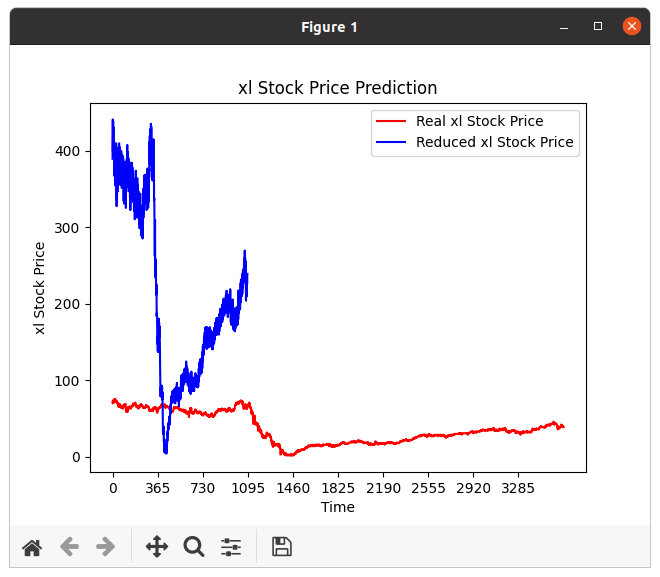
Ύστερα δοκιμάσαμε τα: -window_length = 10 -encoding_dim = 3 -epochs = 100 -test_samples = 300
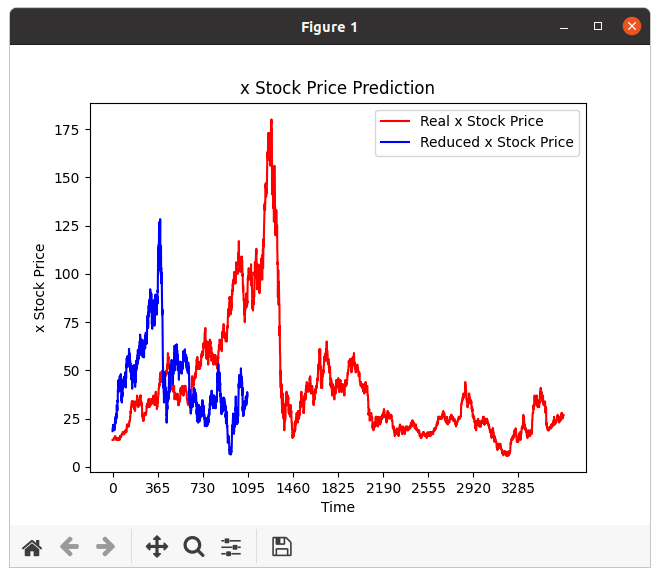
Αυτές οι τιμές ήταν ιδανικές, αφού έχουμε αποτελέσματα που θυμίζουν τις αρχικές μετοχές, απλά σε reduced μορφή, ενώ οι τιμές δεν έχουν μεγάλη απόκλιση από τις πραγματικές.
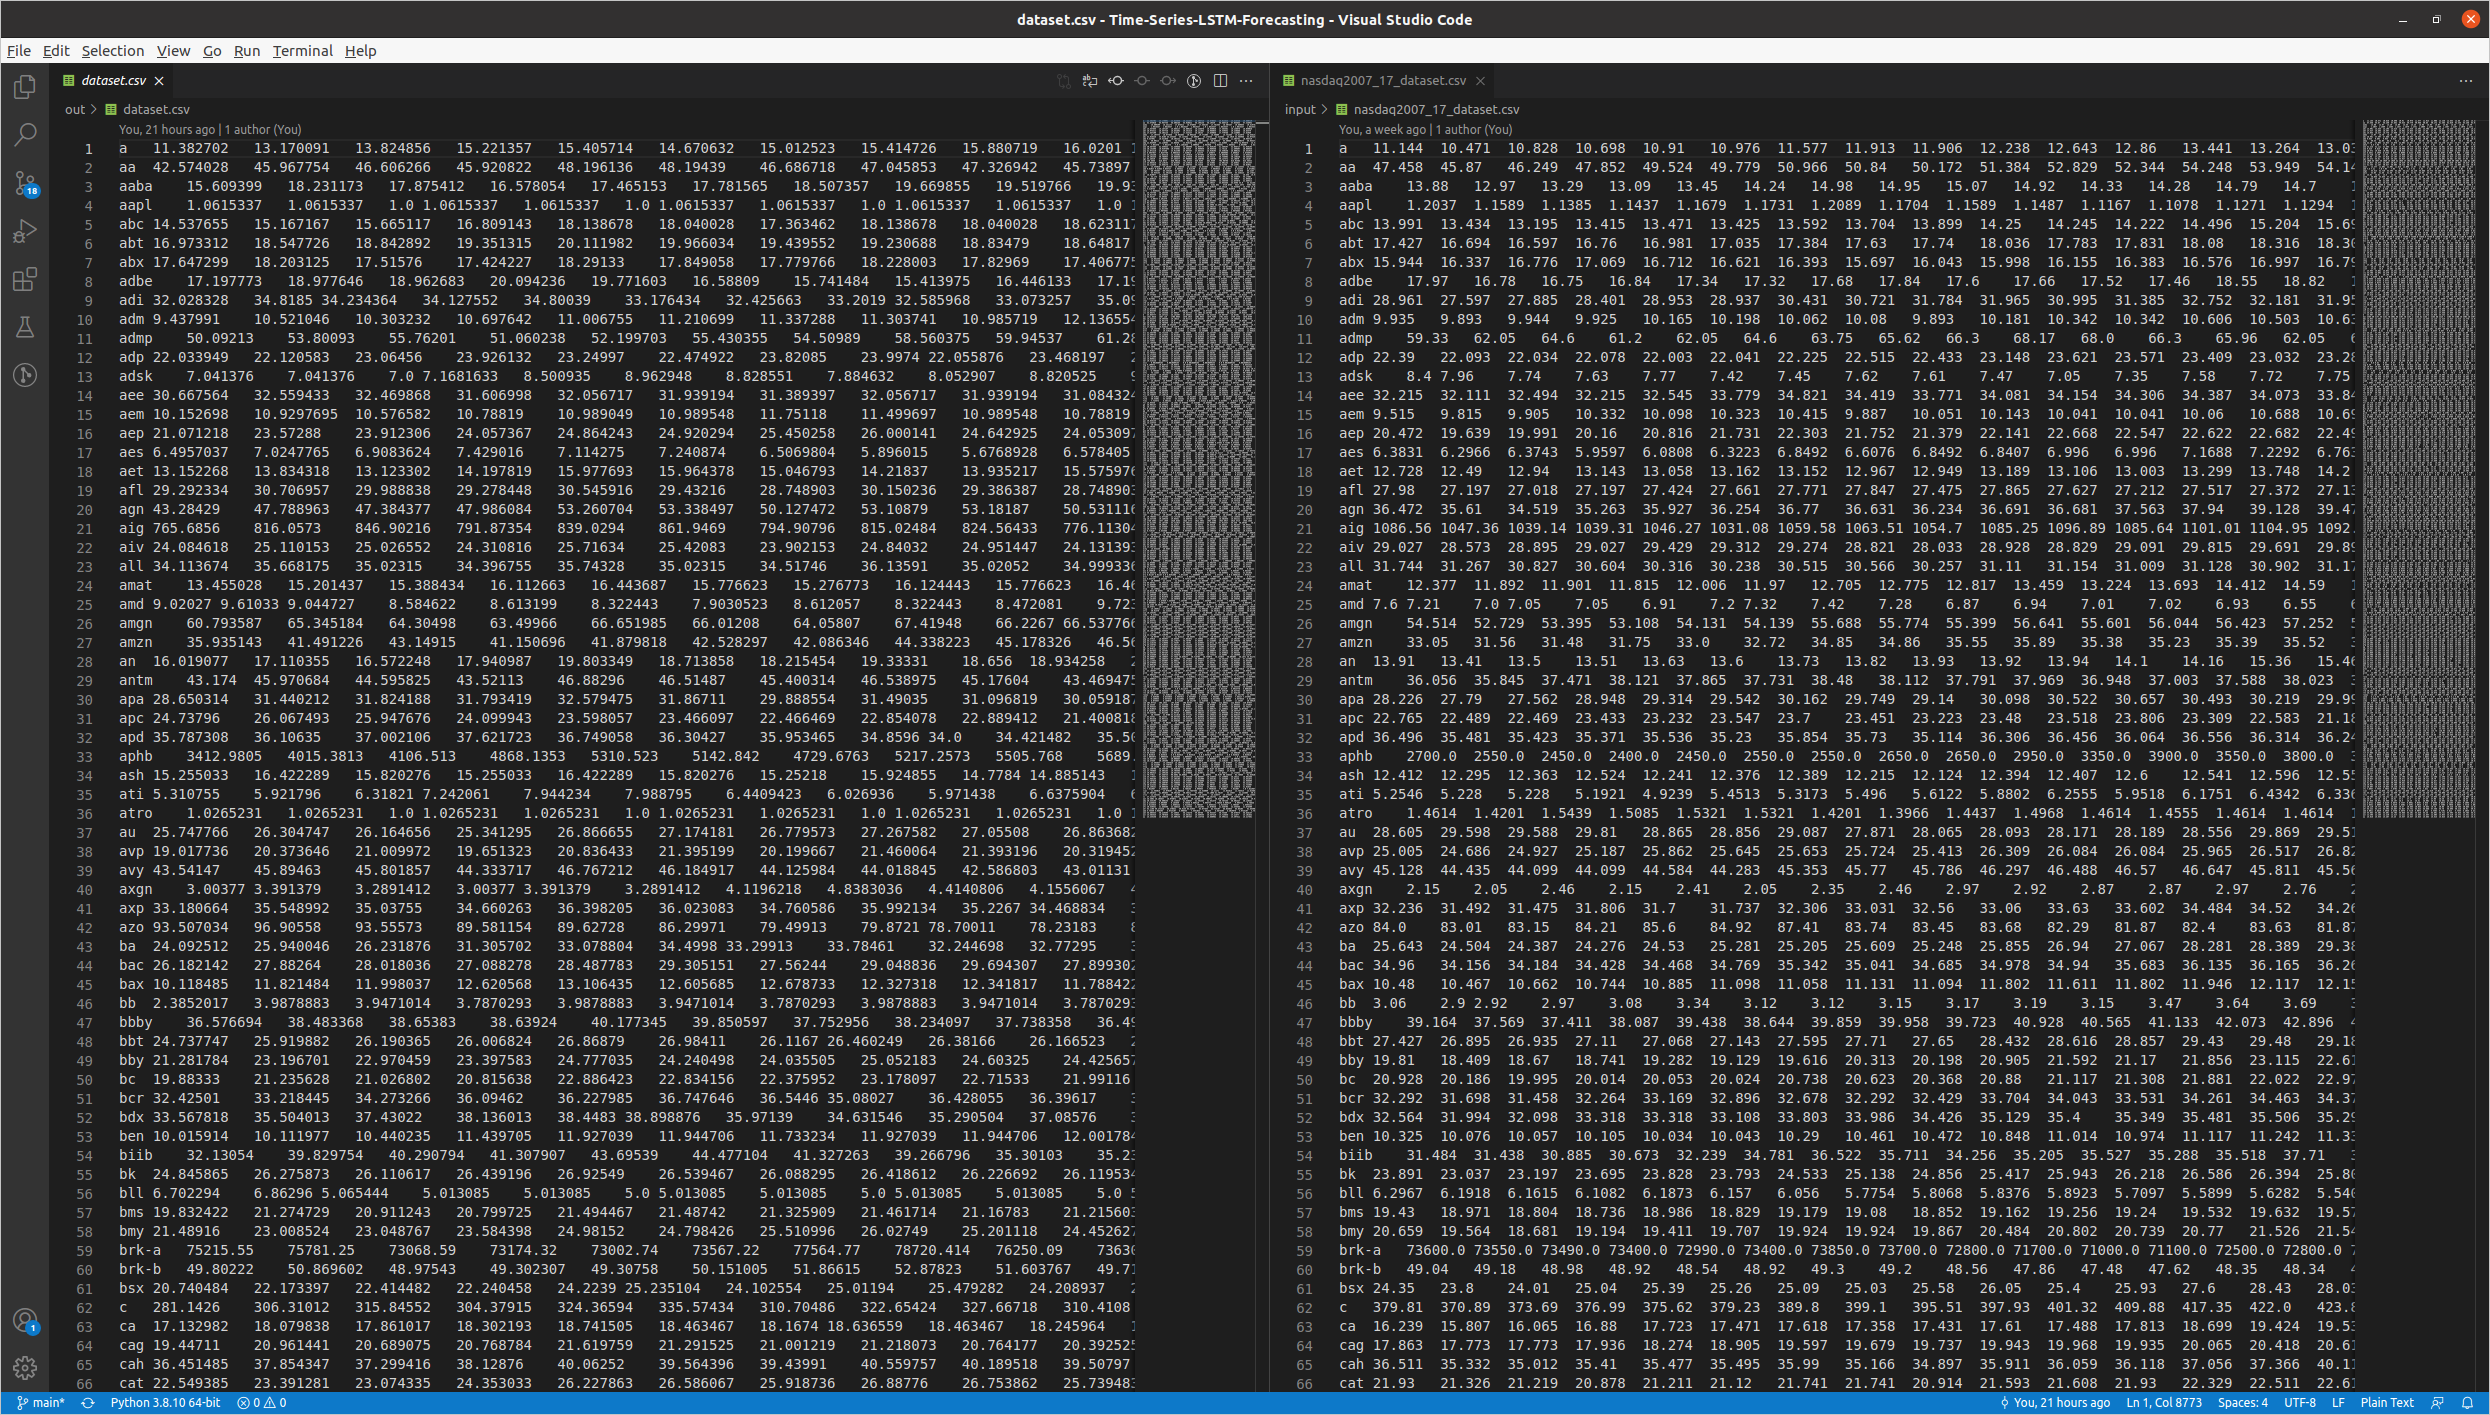
Εδώ εμφανίζονται δίπλα-δίπλα τα 2 αρχεία, για να φανεί ότι οι τιμές κάθε χρονοσειράς είναι παρόμοιες, δηλαδή ότι δεν αλλοιώνεται σοβαρά η αρχική.
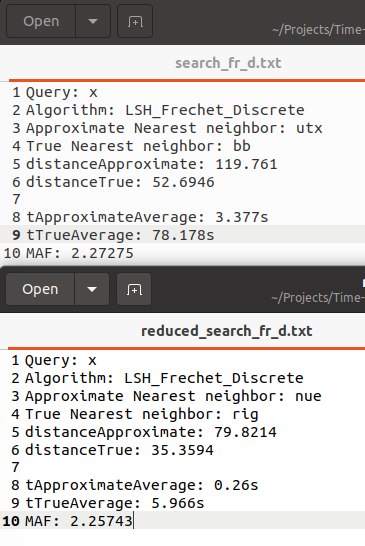
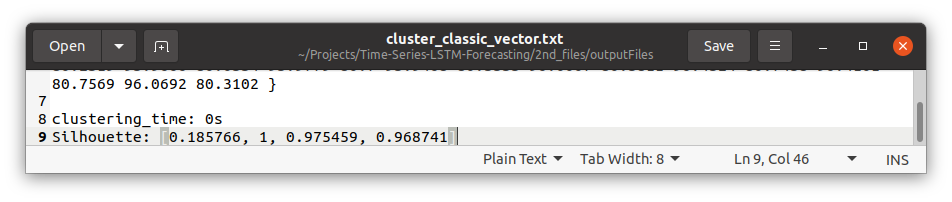
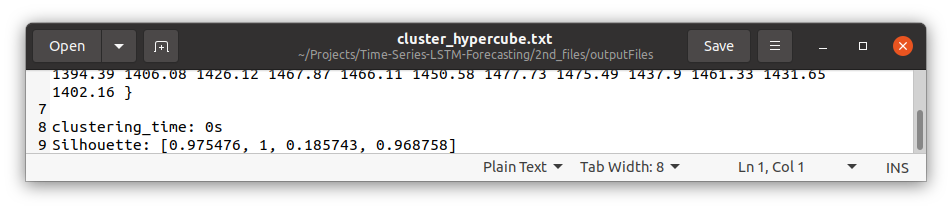
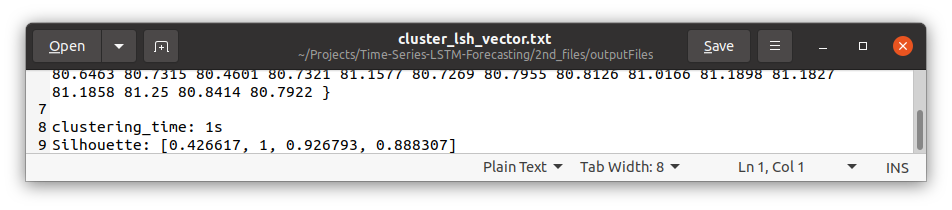
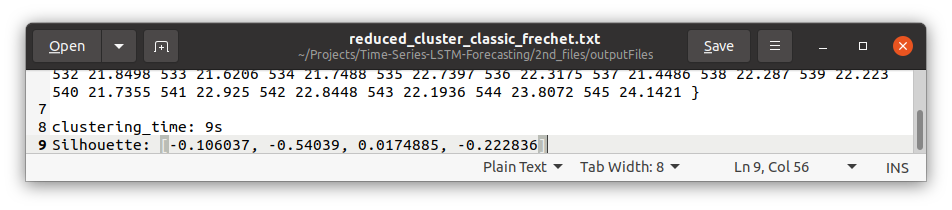
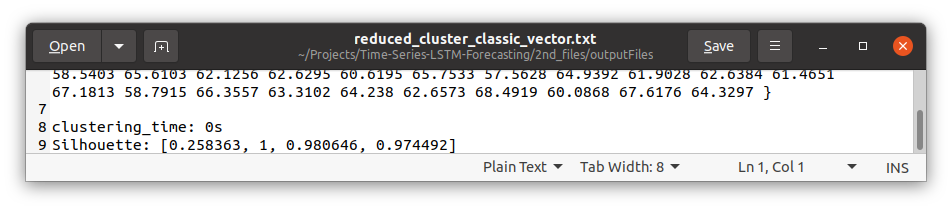
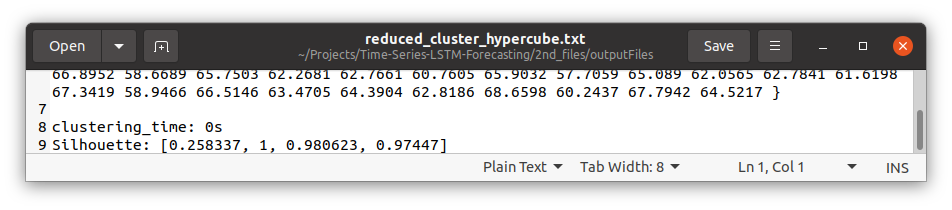
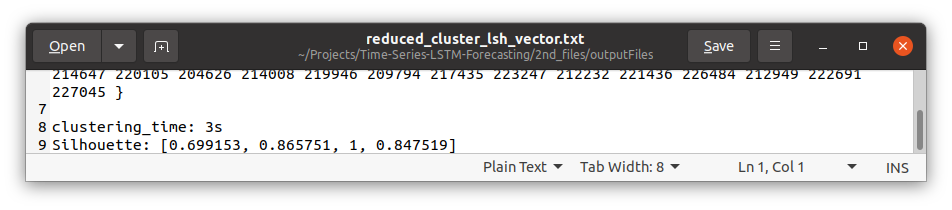
Συγκρίνουμε τα αποτελέσματα και παρατηρούμε ότι: To clustering δουλεύει παρόμοια και στις δύο περιπτώσεις, και παράγει παρόμοια silhouette, επομένως δεν επηρεάζονται οι αριθμοί τόσο ώστε να χαλάσει το clustering. Από την άλλη, το search παρουσιάζει διαφορετικά αποτελέσματα. Συγκεκριμένα τα reduced δεδομένα έχουν λίγο χειρότερο (μεγαλύτερο) MAF, όμως ο χρόνος μειώνεται δραματικά, ιδίως για τις Frechet μεθόδους, που καθυστερούσαν υπερβολικά πολύ με τα δεδομένα μεγέθους 3650.
Εν ολίγοις, θα προτείναμε τη χρήση των reduced δεδομένων, αφού ο χρόνος που εξοικονομούν είναι σημαντικότερος από την μικρή αλλοίωση των αποτελεσμάτων.
Αποσπάσματα από τα output files της 2ης Εργασίας με τα κανονικά αρχεία nasdaq2007_17.csv και με τα reduced datasets που παρήχθησαν στο ερώτημα Γ:
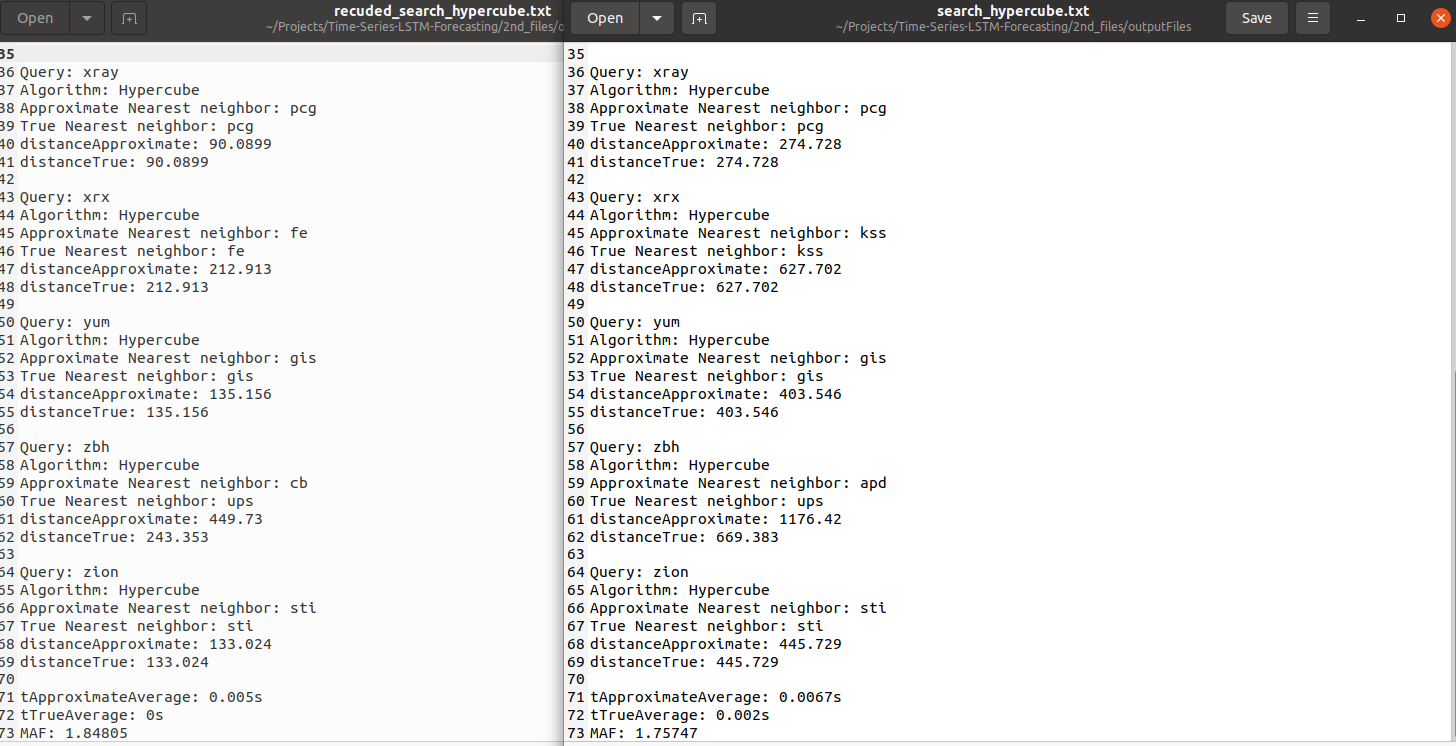
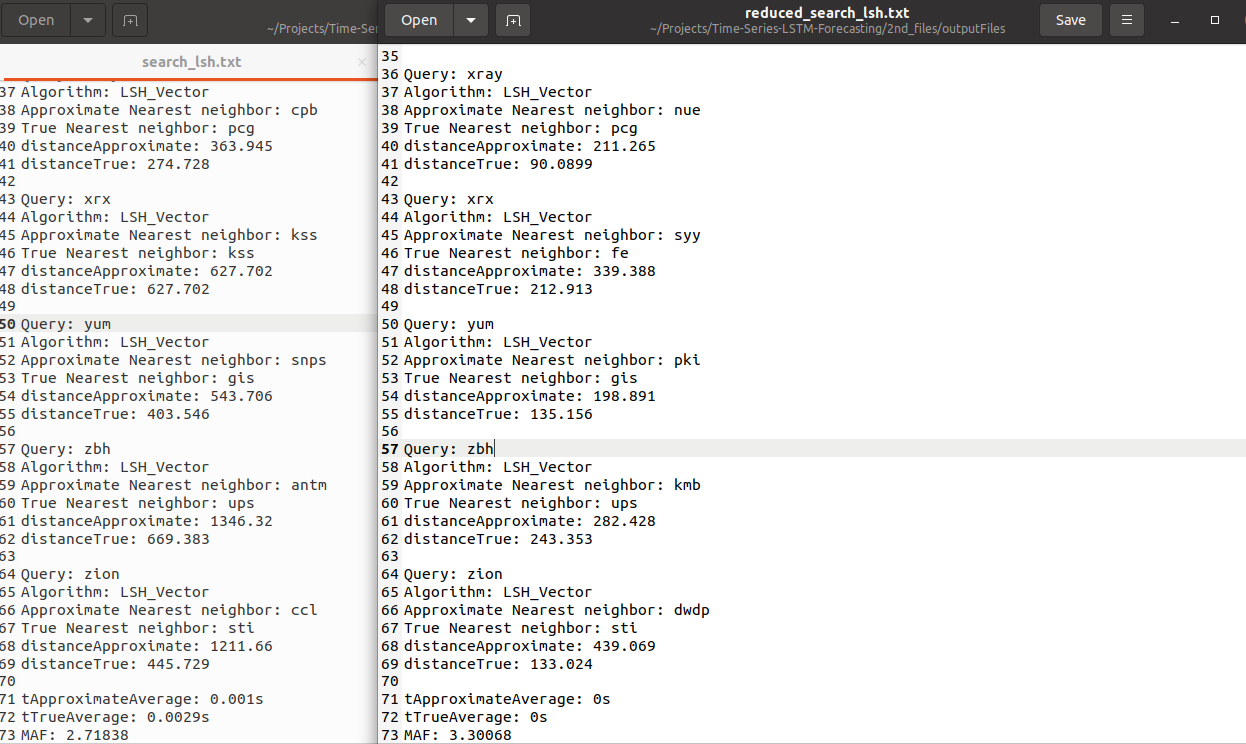
Για την εκτέλεση των αρχείων της Εργασίας 2 με τις τιμές μας, χρησιμοποιούνται οι παρακάτω εντολές: Δ) Search:
./bin/search.out -i input/nasdaq2007_17_dataset.csv -q input/nasdaq2007_17_queryset.csv -o outputFiles/search_lsh.txt -algorithm LSH
./bin/search.out -i input/nasdaq2007_17_dataset.csv -q input/nasdaq2007_17_queryset.csv -o outputFiles/search_hypercube.txt -algorithm Hypercube
./bin/search.out -i input/nasdaq2007_17_dataset.csv -q input/nasdaq2007_17_queryset_one.csv -o outputFiles/search_fr_d.txt -algorithm Frechet -metric discrete
./bin/search.out -i input/nasdaq2007_17_dataset.csv -q input/nasdaq2007_17_queryset_one.csv -o outputFiles/search_fr_c.txt -algorithm Frechet -metric continuous
./bin/search.out -i input/dataset.csv -q input/queryset.csv -o outputFiles/reduced_search_lsh.txt -algorithm LSH
./bin/search.out -i input/dataset.csv -q input/queryset.csv -o outputFiles/recuded_search_hypercube.txt -algorithm Hypercube
./bin/search.out -i input/dataset.csv -q input/queryset_one.csv -o outputFiles/reduced_search_fr_d.txt -algorithm Frechet -metric discrete
./bin/search.out -i input/dataset.csv -q input/queryset_one.csv -o outputFiles/reduced_search_fr_c.txt -algorithm Frechet -metric continuous
Clustering: Classic - Vector
./bin/cluster.out -i input/nasdaq2007_17_dataset.csv -c input/cluster.conf -o outputFiles/cluster_classic_vector.txt -assignment Classic -update Mean_Vector -silhouette
Classic - Frechet
./bin/cluster.out -i input/nasdaq2007_17_dataset.csv -c input/cluster.conf -o outputFiles/cluster_classic_frechet.txt -assignment Classic -update Mean_Frechet -silhouette
LSH Frechet - Mean Frechet
./bin/cluster.out -i input/nasdaq2007_17_dataset.csv -c input/cluster.conf -o outputFiles/cluster_lsh_frechet.txt -assignment LSH_Frechet -update Mean_Frechet -silhouette
LSH Vector - Vector
./bin/cluster.out -i input/nasdaq2007_17_dataset.csv -c input/cluster.conf -o outputFiles/cluster_lsh_vector.txt -assignment LSH -update Mean_Vector -silhouette
Hypercube - Vector
./bin/cluster.out -i input/nasdaq2007_17_dataset.csv -c input/cluster.conf -o outputFiles/cluster_hypercube.txt -assignment Hypercube -update Mean_Vector -silhouette
Our Values: Clustering: Classic - Vector
./bin/cluster.out -i input/dataset.csv -c input/cluster.conf -o outputFiles/reduced_cluster_classic_vector.txt -assignment Classic -update Mean_Vector -silhouette
Classic - Frechet
./bin/cluster.out -i input/dataset.csv -c input/cluster.conf -o outputFiles/reduced_cluster_classic_frechet.txt -assignment Classic -update Mean_Frechet -silhouette
LSH Frechet - Mean Frechet
./bin/cluster.out -i input/dataset.csv -c input/cluster.conf -o outputFiles/reduced_cluster_lsh_frechet.txt -assignment LSH_Frechet -update Mean_Frechet -silhouette
LSH Vector - Vector
./bin/cluster.out -i input/dataset.csv -c input/cluster.conf -o outputFiles/reduced_cluster_lsh_vector.txt -assignment LSH -update Mean_Vector -silhouette
Hypercube - Vector
./bin/cluster.out -i input/dataset.csv -c input/cluster.conf -o outputFiles/reduced_cluster_hypercube.txt -assignment Hypercube -update Mean_Vector -silhouette
Πηγές:
- Forecasting: https://towardsdatascience.com/lstm-time-series-forecasting-predicting-stock-prices-using-an-lstm-model-6223e9644a2f
- Anomaly Detection: https://curiousily.com/posts/anomaly-detection-in-time-series-with-lstms-using-keras-in-python/
- Dimensionality Reduction: https://towardsdatascience.com/autoencoders-for-the-compression-of-stock-market-data-28e8c1a2da3e